통계 세분화와 신뢰도
1. 서론
각 보험사들은 연령별, 상품군별, 상품별, 채널별, 담보별, 질병별 통계를 통해 조금 더 세분화된 결과를 얻고 이를 전략 및 마케팅에 반영하고 싶어한다. 최근 들어서는 “초개인화”라고 해서 극도로 세분화된 개념이 등장하고 때로는 그것이 절대적인 미덕처럼 여겨지기도 한다. 하지만 이러한 세분화에 대한 “과도한 신뢰” 또는 “잘못된 기대”로 인해 과적합(Overfitting)을 초래하고, 필연적으로 편향(Bias)과 오차(Error)를 발생시킨다.
우리가 분석하는 대상은 자사에 쌓인 우리 고유의 데이터지만 이를 그대로 사용하는 것은 다른 차원의 문제다. 이는 이른바 데이터 과학을 이용한 기술적인 과정이 필요하다는 의미가 아니라 지금 우리가 보유하고 있는 데이터가 우리가 알고자 하는 실제 세계에 가까운 지를 확인해야 한다는 의미이다.
예를 들어, 우리 회사에 쌓인 데이터는 과거 언더라이팅 기준을 통과한 사람의 데이터이다. 만약 우리가 특정 질병들을 거절해 왔고 앞으로 그 기준을 “인수”로 변경하고자 한다면, 변경에 따른 손해율을 과거의 데이터로 예측하는 것은 반드시 문제가 된다.
즉, 우리가 다루고자 하는 과제가 무엇이고 이 과제를 다루는데 지금의 Raw 데이터가 이를 어느 정도 정확하게 표현을 하고 있는지 알아야 한다.
사실 너무 뻔하고 간단한 이야기인데 생각보다 많은 사람들이 크게 언급하지 않고, 설명과 계산이 귀찮다보니 “이런 이런 AI기술이 있어서 우리는 다 분석할 수 있고 다 잘 됩니다.”라고 말하는 사람들에 비해 너무 많은 시간과 비용이 들어간다. 실제 프로젝트 상에서는 더 깊고 많은 이야기가 논의되지만, 이번에는 수년간 프로젝트를 진행하면서 느낀 두 가지 내용에 대해서 중점적으로 적어보고자 한다.
- 세분화된 손해율 리포팅 과정에 유지계약 건수가 반영되지 않는다.
- 특정 GA 손해율이 업계 전체 GA 손해율을 모방하지 않는다.
2. 손해율 리포팅 과정에 샘플수와 신뢰구간을 반영하자.
우리가 알고자 하는 세계를 Sample Space라고 한다면 우리가 판매한 계약은 다음과 같이 하나의 바스켓으로 표현할 수 있다.
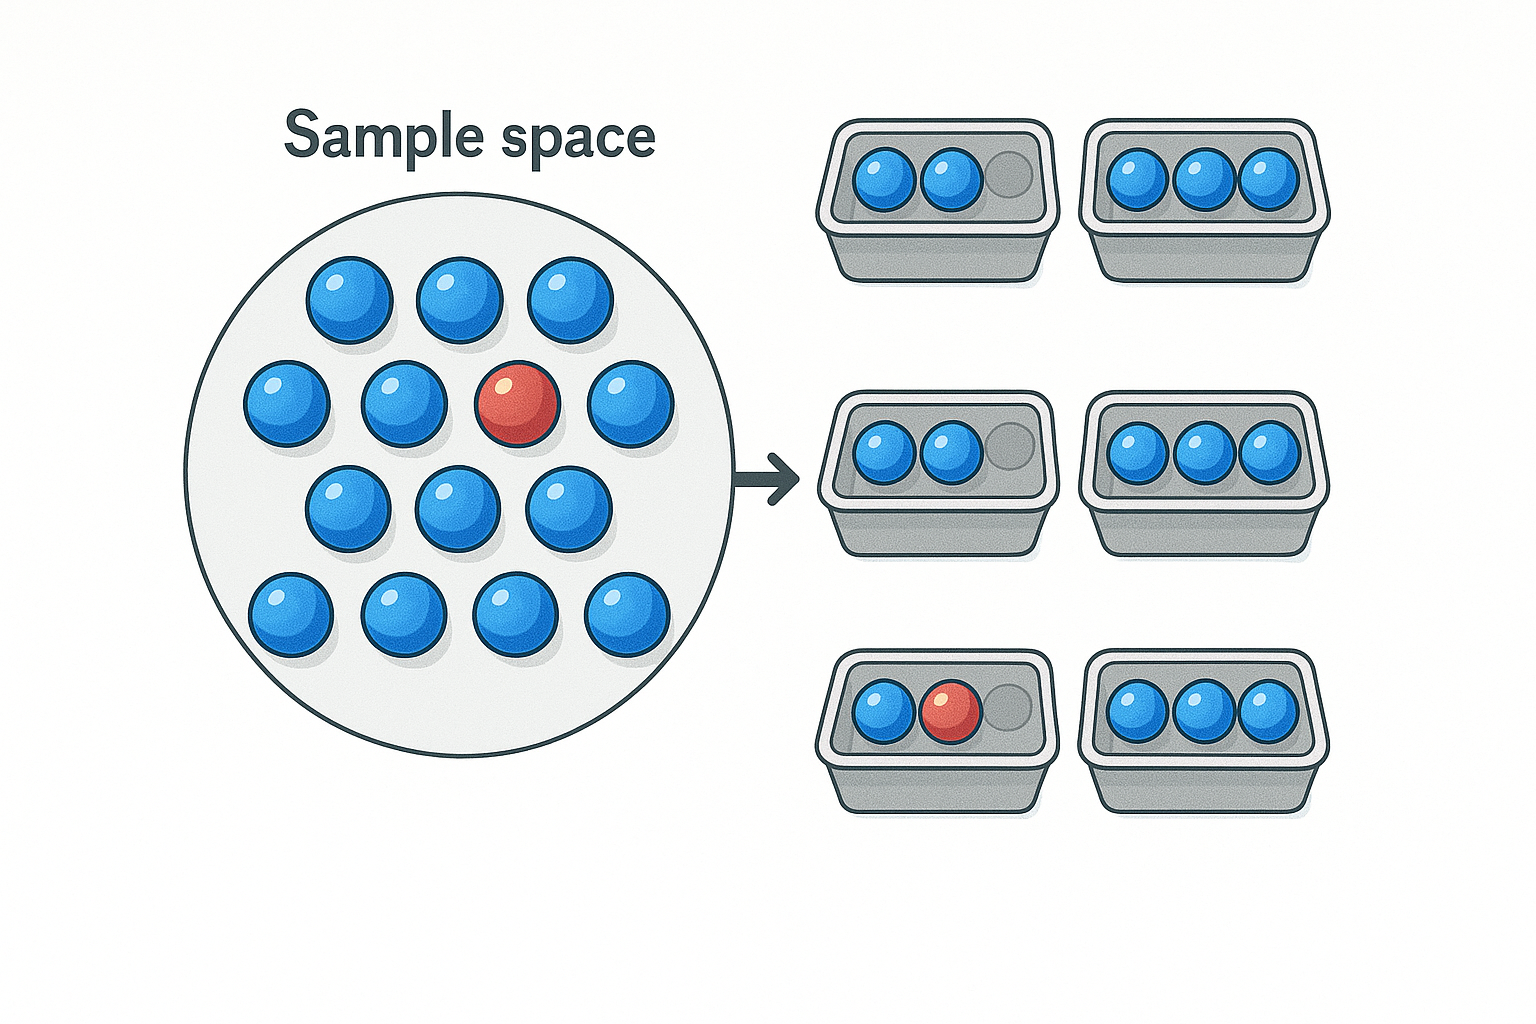
즉, 전체 모수(≈ 업계 전체 대상 고객)에서 빨간공을 고를 확률은 1/14이지만(≈ 7.14% 업계 전체 손해율), 내가 고른 3개의 공(≈ 자사 고객)안에 빨간공이 있을 수도 있고 없을 수도 있다, 빨간공을 가지고 있었다면 나는 확률을 1/3 (33.3%)로 점추정(≈ 자사고객의 손해율)하였을 것이고, 없었다면 0/3 (0%)이라고 생각했을 것이다.
만약, 특정 데이터의 특정 질병의 발생률이 5% 정도로 알려져 있다고 하자. 우리가 이 발생률을 담보하기 위해 95% 신뢰구간하에 ±5% 즉, 4.75% ~ 5.25% 사이에서에서 추정하기 위해서 필요한 샘플수(≈ 인원수 ≈ 판매건수)는 7,299명이다. 하지만 95% 신뢰구간하에 ±20% 즉, 4.00% ~ 6.00%사이에서 추정한다면 우리가 필요한 샘플수는 1,825명에 지나지않는다. (Wilson 방식 활용)
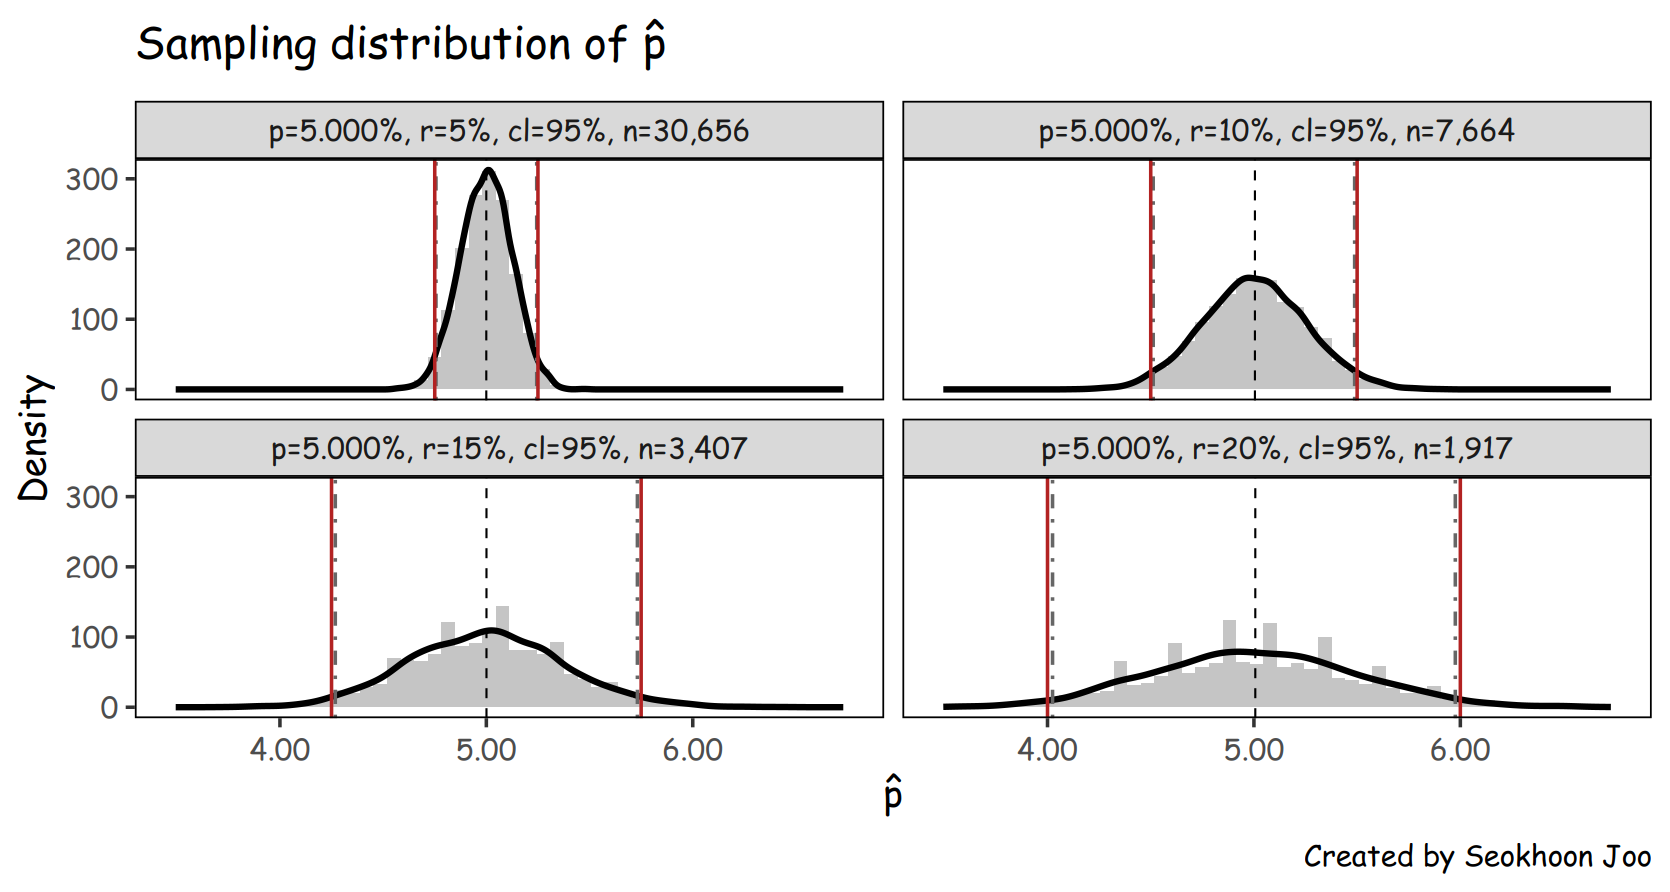
더 정확한 통계를 위해 더 작은 범위(±R%)를 함수에 설정하고자 한다면, 기하급수적으로 많은 샘플수를 가져가야 한다. 이론적으로 5% 발생률의 경우 ±2%규모에서 추정하려면 약 20만 정도가 필요하지만, 이것을 ±1%로 줄일 경우 필요한 샘플수는 75만으로 늘어난다
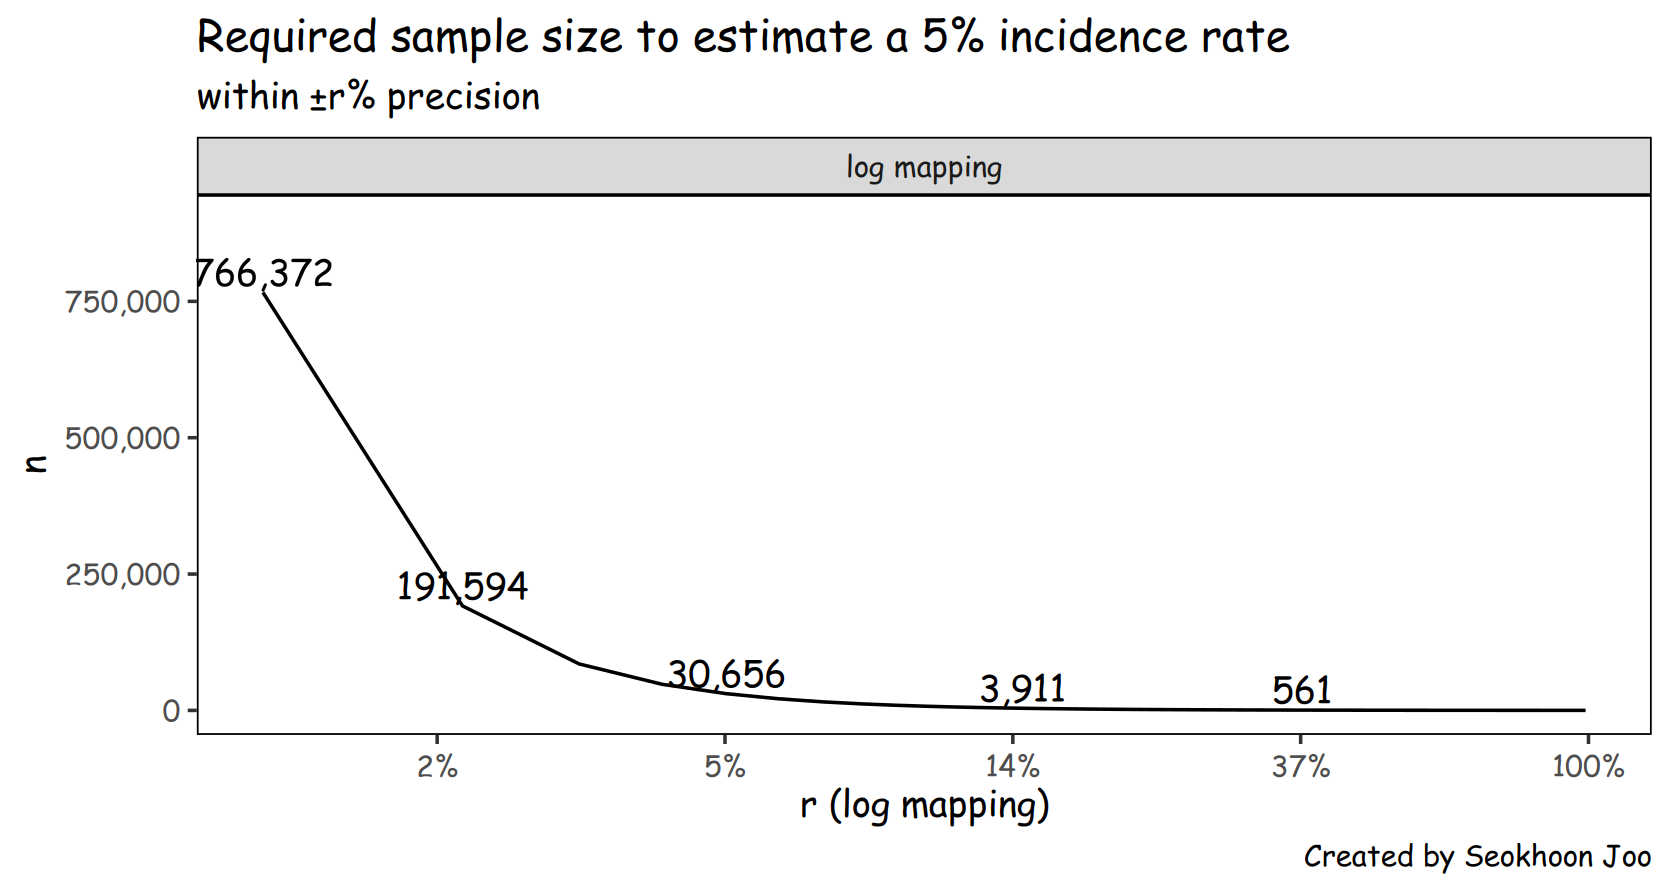
만약 암이나 희귀질병이라고 생각해보자, 발생률 0.1%로 알려진 질병을 95% 신뢰구간하에 ±5%에서 추정하기 위해서 필요한 인원은 154만 정도이다. 처음 우리가 생각한 세분화 통계에 대해 잘 생각해보자. 누군가 우리의 데이터를 정확히 보지 않고도 AI든 Machine Learning이든 정확하게 구할 수 있다고 한다면, 믿을 수 있겠는가?
사실 이 과정은 계리, 상품개발 과정에서 감독원 기준에 녹아져 있는 경우가 있다. 하지만, 일상적으로 이 과정을 이해하고 반영하는 것을 통해 우리가 믿을 수 있는 과학적인 근거와 범위에 대해 우리 나름의 정확한 판단기준을 가질 수 있읕 것이다. 예를 들어 A/E (위험손해율)에 “판매건수”, “신뢰구간”, “신뢰구간을 반영한 위험 손해율” 등을 같이 리포팅하는 것은 매우 중요한 의사결정 판단 근거가 될 것이다.
3. GA 손해율은 반드시 협약 GA수에 따라 다르게 분석되어야 한다.
결론적으로 협약GA(혹은 활동GA)가 1~2개에 집중되면 업계 평균과의 괴리가 크고(운에 좌우), 수십개라면 평균에 훨씬 수렴한다는 것을 기억해야 한다. 프로젝트를 진행할 때 “GA손해율이 나쁘다”는 이야기를 많이 듣는다. 다양한 보험사의 프로젝트를 통해 틀린 말이 아니란 것은 경험적으로, 종합적으로 알고 있지만, GA손해율이 나쁘다고 결론짓기 위해서는 GA수와 샘플수와 연령, 담보 Mix등이 엄청난 영향을 미친다.
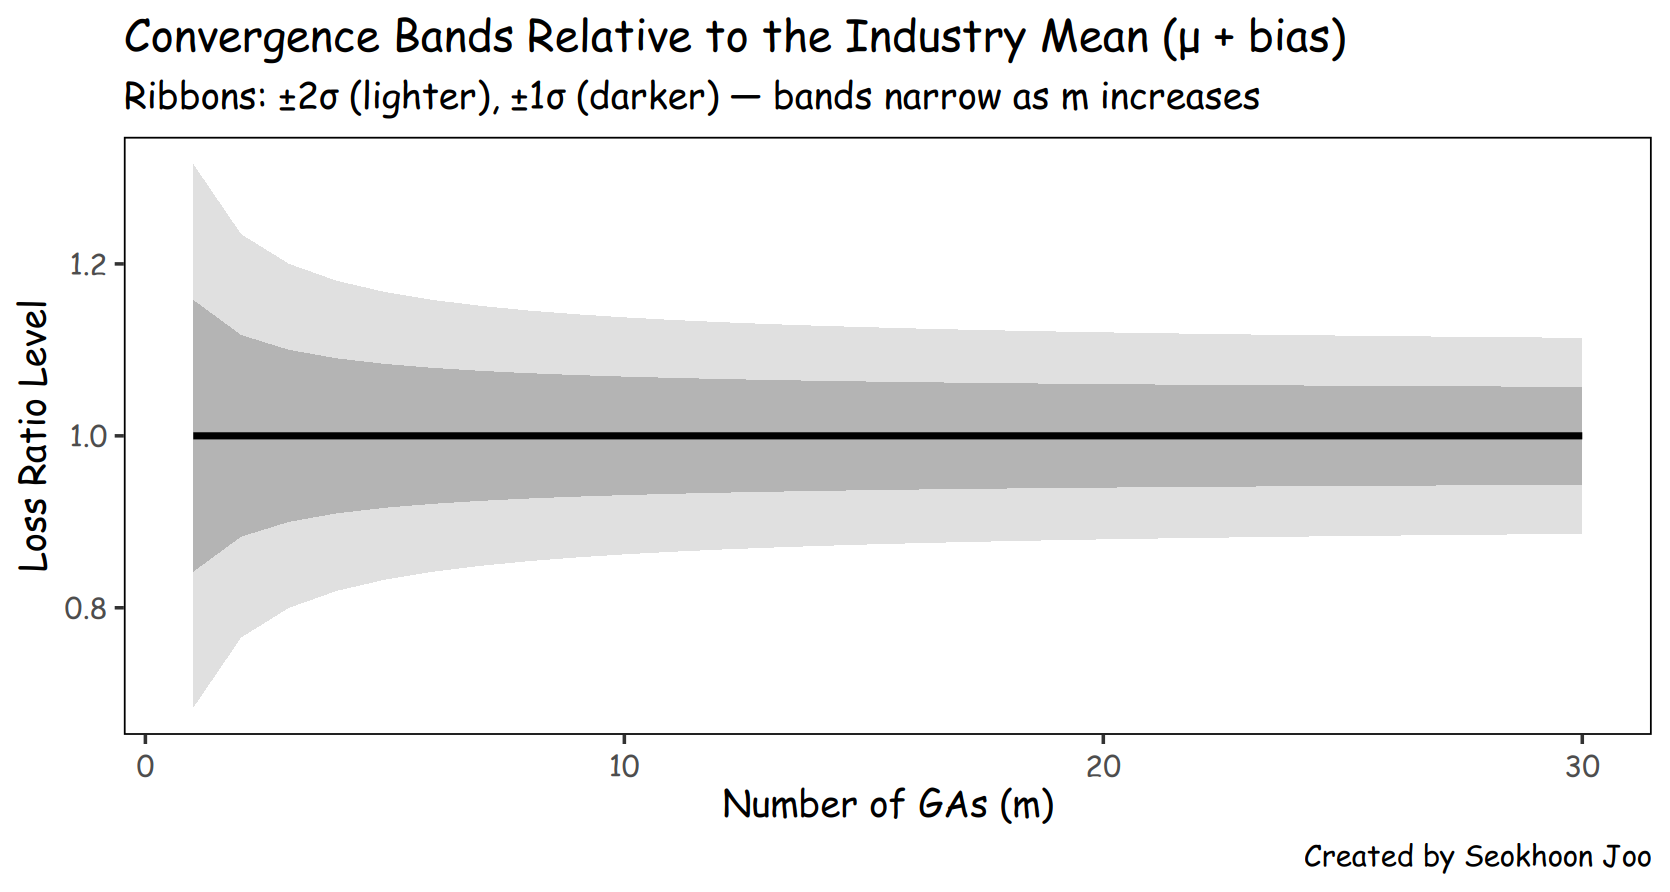
3.1) 협약 GA개수가 늘어남에 따라 손해율 분산은 줄어든다.
논의를 간단히 하기 위해 업계 GA 손해율을 θ_g 라고 하고, 이들이 평균 μ와 분산 τ²를 갖는다고 가정하자. 회사가 협약한 m개의 GA 손해율 평균(익스포저 가중 평균) θ̄_m을 보면,
\(\bar{\theta}_m \sim N(\mu + \text{bias},\ \tau^2/m + \bar{\sigma}^2)\)
bias: 선택 바이어스(selection bias): 업계 평균과 다른 성격의 GA를 골라 계약했다면, 개수를 늘려도 바이어스는 남음τ²/m: GA 개수(m)가 늘수록 업계 평균으로 가까워짐.σ̄²: 각 GA의 익스포저(판매건수)가 커질수록 작아짐.
업계 GA 간 표준편차를 τ라고 하자 (예: A/E 기준으로 0.15 = 15%). 측정오차가 크지 않다고 가정하면,
m = 1: 업계 평균과 기대적 편차 ≈τ→ 약 15%(가정)m = 30: 기대적 편차 ≈τ/√30 ≈ 0.15/5.48 ≈ 2.7%
목표 오차 d를 원하면 대략 m ≈ (τ/d)²
예) τ = 15%, d = 5%면 m ≈ 9개 필요 (측정오차 무시 시).
결론적으로, 활동 GA개수가 늘어날수록 분산은 줄어든다.
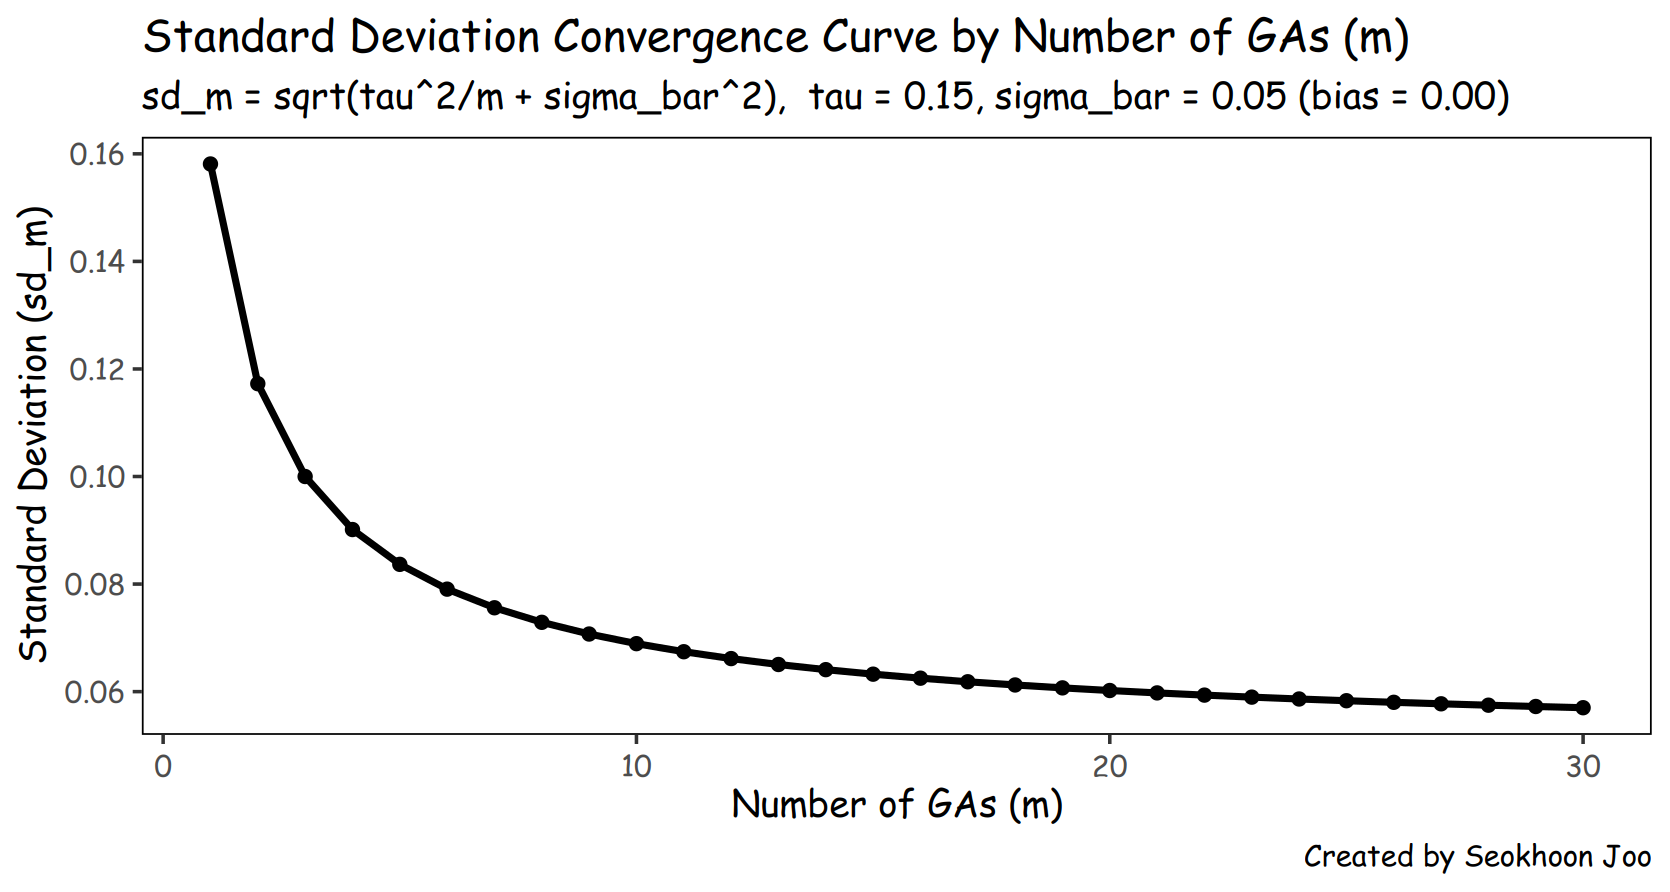
또한, 다음과 같이 위험 손해율 측정오차가 점점 줄어든다.
3.2) 자사 데이터의 대표성에 따라 체계적 차이가 지속된다.
무작위 표본이 아니면 (특정 연령·상품·지역·설계사 프로필이 치우친 GA 위주) selection bias ≠ 0이므로, m을 늘려도 업계 평균과의 체계적 차이가 지속될 수 있다. 실제로 분석해보면 GA채널의 손해율이 FC채널보다 나쁜데 Mix상 특정 구간에서만 나쁜 구간이 있고 다른 구간에서는 차이가 없는 경우도 많다.
그래서 다음을 반드시 병행해야 한다.
- 믹스 비교(Mix similarity):
우리 회사 GA 믹스 vs 업계 Mix 대표성 점검 - 층화 표준화(Standardization):
업계 분포(연령×성별×가입금액×상품 등)로 가중 표준화 A/E 비교
결론적으로 자사 GA손해율에 대해서 분석할 때는 반드시 다음을 고려하자.
- 활동 GA 소수: 변동성 큼, 업계와의 괴리 크다 → 표준화 + 신뢰구간 반드시 제시, 무조건 나쁘다는 판단 보류/시범계약 권장.
- 활동 GA 다수: 평균값이 업계에 상당히 근접. 검증 후 그대로 활용.
4. 결론
이처럼 숫자를 다루는 재무, 계리 뿐만아니라 상품, 언더라이팅, 마케팅 또한 동등한 차원의 혹은 더 세분화된 차원의 분석이 필요하다. AI의 시대, 많은 사람들이 데우스 엑스 마키나 같은 모델이 있고 우리의 데이터를 보기도 전에 모든 문제를 해결해줄 거라고 이야기하고 있다. 이 말에 의지하기 전에 우리는 우리의 데이터가 어떤 세계를 표방하고 어떤 한계를 지니고 있는지 생각해 둘 필요가 있다. 그것이 현업이 앞으로 가치판단을 위해 가지고 있어야 할 지혜이다.